기술과 과학
세레브라스, 3조 매개변수 AI 모델을 웨이퍼 59장에 나누는 배치 예시 공개
가중치를 칩 내부 메모리에 고정...중간 계산 결과만 전달해 데이터 이동 시간 단축
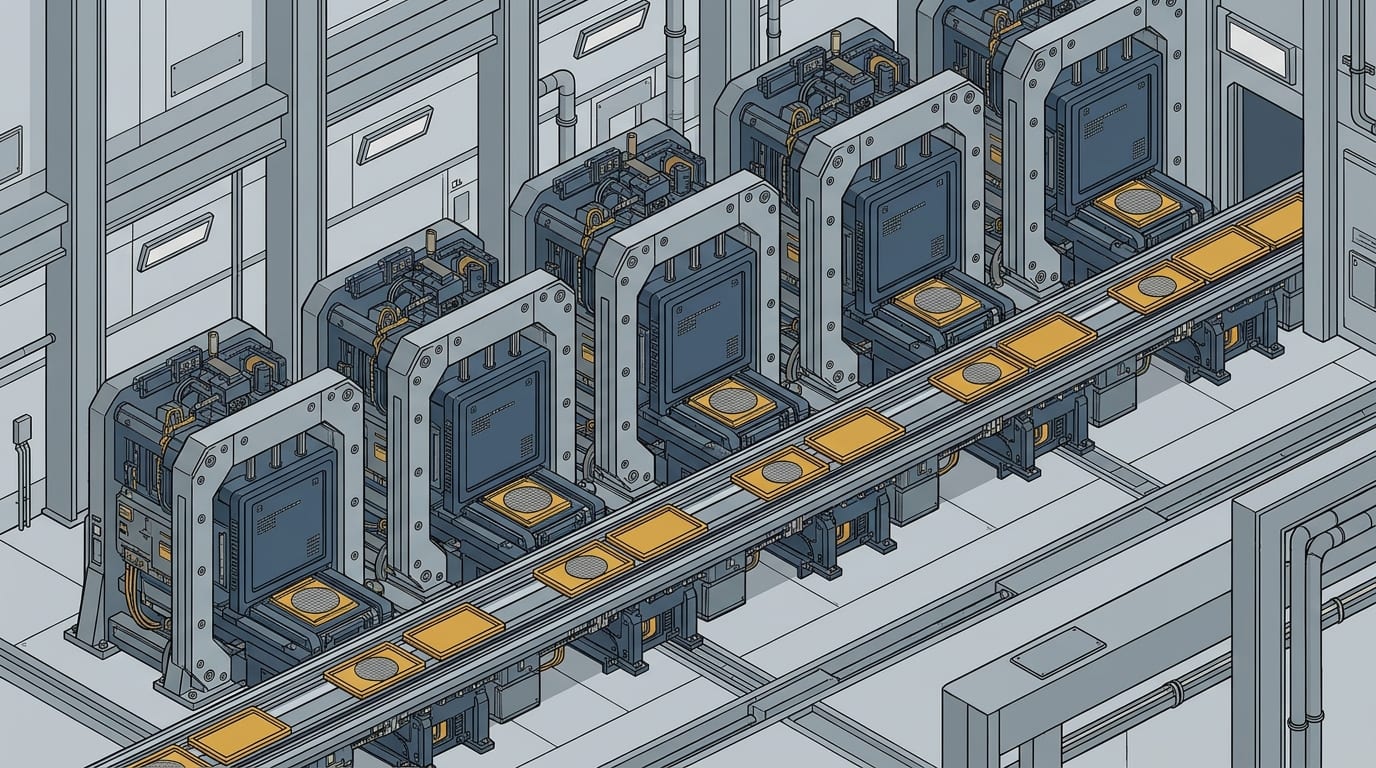
세레브라스가 22일 3조 개 매개변수 모델을 웨이퍼 59장에 나누어 배치하는 계산 예시를 발표했다. 예시에 사용한 모델은 키미 K3다. 웨이퍼 한 장의 칩 내부 메모리 용량은 44기가바이트로, 이 모델의 가중치를 4비트로 저장하면 가중치만 1.5테라바이트가 필요하다. 세레브라스는 모델을 웨이퍼 여러 장에 나누어 배치하면서 각 요청의 문맥을 저장할 공간까지 확보한다.
세레브라스는 웨이퍼 규모의 단일 칩에 정적 메모리(SRAM)를 집적해 연산 장치 가까이에 가중치를 둔다. 데이터 이동을 줄여 토큰 생성 속도를 높이려는 방식이다. GPU 추론에서도 입력을 한꺼번에 처리하는 단계와 답변의 토큰을 하나씩 생성하는 단계는 병목이 생기는 지점이 다르다. 토큰 생성 단계에서는 고대역폭 메모리(HBM)에서 데이터를 읽어오는 대역폭에 따라 속도가 제한될 수 있다.
빠른 메모리라도 용량은 한정돼 있다. 3조 개 매개변수를 각각 4비트로 저장하면 가중치만 1.5테라바이트를 차지한다. 세레브라스는 가중치를 저장하는 데 필요한 이 용량을 모델의 93개 계층에 나누어 계층당 약 16기가바이트로 계산했다. 이 계산에 따르면 메모리 용량이 44기가바이트인 웨이퍼에 계층 2개를 배치할 수 있지만 모든 계층을 2개씩 배치하지는 않는다. 계층마다 문맥을 저장하는 방식이 다르기 때문이다.
키미 K3의 선형 어텐션 계층 69개는 요청마다 크기가 작고 일정한 상태 정보를 유지한다. 선형 어텐션 계층은 문맥이 길어져도 이전에 처리한 토큰의 정보를 모두 따로 저장할 필요가 없어 웨이퍼 한 장에 계층 2개씩 배치할 수 있다. 전체 어텐션 계층 24개에는 각 요청에서 이전에 처리한 토큰의 정보를 키와 값으로 저장하는 KV 캐시가 필요하다. 세레브라스는 이 계층을 한 장에 하나씩 두어 나머지 메모리를 캐시에 할당한다. 선형 어텐션 계층에 할당한 35장과 전체 어텐션 계층에 할당한 24장을 합하면 59장이다.
이렇게 배치하면 각 계층의 가중치를 해당 웨이퍼의 SRAM에 상주시킬 수 있다. 요청이 들어오면 첫 웨이퍼가 담당 계층의 연산을 수행한 뒤 그 결과인 활성화값을 다음 웨이퍼로 전달한다. 다음 웨이퍼는 내부 메모리에 저장된 가중치로 연산을 이어간다. 웨이퍼 사이에서 가중치 대신 중간 계산 결과를 전달할 때 세레브라스가 제시한 이더넷 기반 통신의 전달 지연은 웨이퍼 사이 한 구간당 약 2마이크로초다.
가중치를 칩 내부 메모리에 고정하면 개별 요청을 처리할 때 데이터 이동에 드는 시간이 줄어든다. 세레브라스는 이 구조를 설명하며 수조 개 매개변수 모델의 토큰 생성 속도로 초당 1,000~2,000개 이상을 제시했다.
여러 요청을 처리하려면 별도의 운용 방식이 필요하다. 요청 하나가 모든 단계를 통과할 때까지 기다리면 다른 웨이퍼는 가동하지 못한다. 세레브라스는 서로 다른 요청을 파이프라인에서 함께 처리한다. 세 번째 단계에서 요청 A를 계산하는 동안 두 번째 단계에서는 요청 B를, 첫 번째 단계에서는 요청 C를 처리하는 식이다. 세레브라스는 여러 요청을 처리하면서 각 단계를 계속 가동해 장치의 활용률과 전체 처리량을 높인다. 세레브라스는 실제 운용에서 예시에 제시한 계층 구분보다 단계를 더 잘게 나눈다.
동시에 처리할 수 있는 요청 수는 전체 어텐션 계층에 확보한 캐시 공간에 따라 달라진다. 공식 예시에서는 웨이퍼의 메모리 용량 44기가바이트에서 가중치 약 16기가바이트를 제외한 28기가바이트를 캐시에 쓴다. 가중치는 4비트, KV 캐시는 8비트, 문맥은 요청당 25만6000토큰으로 가정하면 이 계층에서 요청 하나에 필요한 캐시 용량은 약 147메가바이트다. 따라서 이 배치의 캐시 공간을 요청 하나에 필요한 캐시 용량으로 나누면 동시에 처리할 수 있는 장문 요청 수는 약 190건이다. 이 수치는 파이프라인에서 처리 중인 요청 수로, 서비스에 접속한 전체 이용자 수와는 다르다. 문맥이 짧아지면 요청마다 필요한 캐시 용량도 줄어든다.
각 단계에서는 요청을 하나씩 처리하거나 작은 묶음인 마이크로배치로 처리할 수 있다. 세레브라스는 묶음을 작게 하면 개별 요청의 응답이 빨라지고 크게 하면 전체 처리량이 늘어난다고 설명한다. 이 59장 배치에서도 요청별 문맥을 저장할 캐시 용량의 한도 안에서, 개별 요청의 응답 속도와 전체 처리량 중 무엇을 우선할지에 따라 묶음의 크기를 조절한다.
이 글이 어땠나요?
눌러 주시면 다음 글을 쓸 때 소중한 참고가 됩니다.